🧭 はじめに
「Azure の請求額が先月より増えているけれど、原因が分からない」——私たちが企業様からよく伺う悩みのひとつです。コストが読めない、どのリソースが効いているのか分からない。そうした状態は、クラウドが当たり前になった今でも変わりません。
ただ、この「むだを削ぎ落として軽くする」という感覚は、決してクラウド時代に生まれたものではありません。むしろ、ディスクもメモリも回線も足りなかった時代に、いや応なしに身についた考え方だと感じています。今回は少し毛色を変えて、私自身がハードウェアと OS に向き合ってきた経験をたどりながら、軽量であることがなぜ今のクラウド設計やコスト最適化に直結するのかを考えてみます。
この記事で扱うテーマは、次のとおりです。
- Slackware Linux を FDD(フロッピーディスク)20 枚からインストールした経験
- SCSI 500MB ディスクの自作 PC と、当時の「軽量 OS」の意味
- ISDN 128k のネットワークと、限られた回線でのリモートアクセス
- Docker のベースイメージとコンテナの軽量化
- なぜ Linux は「純粋なマルチスレッド」ではないのか
一見すると懐かしの昔話ですが、根っこにある問いは今と同じです。「限られたリソースで、どう最大の成果を出すか」。この問いに答え続けてきた歴史が、コンテナや FinOps につながっていると考えています。
💾 Slackware Linux を FDD 20枚から入れた日
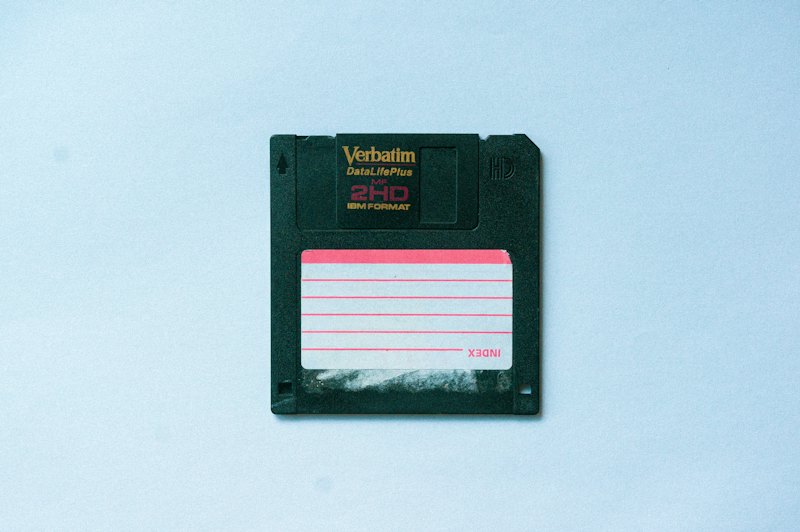
Slackware のインストールは、20 枚を超えるフロッピーディスクとの格闘でした。(写真: Unsplash)
Intel PC で UNIX が動く!!
大学在籍中、研究室に Windows 3.0 と Sun OS がありました。Sun OS はネットワークに繋がっていて、インターネット(たしか JUNET だったと思う)を使って、アメリカへ接続したことを覚えています。接続してみて単に 世界とつながった! と感動しました。
社会人になって UNIX で開発する機会がありました。確か、Sun Solaris のサーバだったと思います。ウィンドウシステムがとっても新鮮で夢中になりました。
最初に Linux と本格的に向き合ったのは、自分で組んだ Intel Pentium 90MHz の フルタワーPC に Slackware Linux を入れたときでした。当時はインストールメディアが CD-ROM ではなく、3.5 インチのフロッピーディスクです。ベースとなる「A」セットだけでも十数枚、ネットワークや開発ツールを含めると、優に 20 枚を超えていました。
インストールは、まさに根気の作業でした。1 枚目で起動し、プロンプトに従って次のフロッピーを差し替える。読み込みエラーが出れば、その 1 枚を焼き直して最初からやり直しです。20 枚のうち 1 枚でも不良があれば、その日の作業は水の泡でした。
Linux の基本コマンドやネットワークのことを覚え始めたのはこの頃でした。幸いなことに Linux コマンドは今でも有効です。
🪶 自作 UNIX PC と軽量OSという美学
SCSI の時代は、拡張カード 1 枚との相性が全てを決めました。(写真: Unsplash)
当時の自作 PC は、今のようにパーツを選んで差し込めば完成、というものではありませんでした。特にこだわったのが SCSI のディスクです。今でも覚えています。IDE より高速で信頼性も高い一方、専用の SCSI ホストアダプタ(Adaptec AHA-2940)が必要で、IRQ や I/O ポートの設定、ターミネータの終端処理まで、すべて手作業でした。お弁当箱くらいのサイズのディスク容量は 500MB。今のスマートフォンの写真数枚分に過ぎませんが、当時は「大容量」でした。
OS のサイズは、数十MBでした。Windows に比べてダントツに少なかったのです。本当に必要なものだけを詰め込んだ、という印象です。
🌐 ネットワーク、ISDN 128kのリモートアクセス
限られた回線を前提に、必要な操作だけを遠隔で行うよう設計していました。(写真: Unsplash)
次に夢中になったのが、ネットワークです。当時、自宅や小規模拠点からサーバーへつなぐ手段として使われていたのが ISDN でした。ISDN の基本インターフェース(BRI)は 2 本の B チャネル(各 64kbps)+ 1 本の D チャネル(16kbps) で構成されます。この B チャネルを束ねるマルチリンク PPP を使うと、実効 128kbps の回線になります。
128kbps というと、今の光回線の 1 万分の 1 以下です。Windows の RDP プロトコルを使うと画面が表示されるまでに1分程度かかりました。白黒にするなど工夫はありましたが、操作をするにも非常にストレスでした。そこで Linux です。CLI でコマンドを操作することで、必要最低限の命令実行でなんとか作業を行うことができました。
ISDN では、必要になったときだけ回線をつなぎ、使い終わったら切る「ダイヤルアップ」的な運用が基本でした。使っていない時間はコストがかからない。この感覚は、クラウドの従量課金や、使っていないリソースを止める自動シャットダウンの考え方にそのまま通じます。
🐳 Linux と Docker のベースイメージ
コンテナ技術の本質は、中身を問わずに運べる「標準化」にあります。(写真: Unsplash)
時は流れ、サーバーはコンテナの時代になりました。Docker を使い始めて最初に驚いたのは、ベースイメージの選び方が、そのまま軽さとセキュリティに効いてくるという点でした。
フル機能の OS イメージは数百 MB あり、攻撃対象となるパッケージも大量に含まれます。一方で Alpine のような軽量ディストリビューションや、シェルすら持たない distroless イメージを使えば、数十 MB まで抑えられます。
不要なものを削ることは、軽量化とセキュリティ強化を同時に達成する。マルチステージビルドを使えば、ビルド用の重いイメージと実行用の軽量イメージを分離できます。
# Dockerfile
# ビルドは重いイメージで行い、実行は軽量なベースに成果物だけをコピーする
FROM node:20-alpine AS build
WORKDIR /app
COPY package*.json ./
RUN npm ci
COPY . .
RUN npm run build
# 実行用はシェルを持たない distroless イメージ
FROM gcr.io/distroless/nodejs20-debian12
WORKDIR /app
COPY /app/dist ./dist
CMD ["dist/index.js"]詳しい考え方は 下記の Docker 公式ドキュメント(Base images) や Distroless プロジェクト にまとまっています。コンテナイメージの脆弱性スキャンについては、DevSecOps 導入支援の事例記事 でも触れています。
Docker 公式ドキュメント(Base images)

Distroless プロジェクト
🧵 なぜ Linux は「純粋なマルチスレッド」ではないのか
Linux では、スレッドは独立した概念ではなく、資源を共有する「タスク」として扱われます。(写真: Unsplash)
軽量化やコンテナを語るうえで、避けて通れないのが実行モデルの理解です。ここで、Linux のスレッドの扱いについて触れておきます。結論から言うと、Linux は「純粋なマルチスレッド」とは言い切れない、という特徴があります。
Linuxにおいて「スレッド」は、カーネルから見ると独立した存在ではなく、メモリ空間などのリソースを共有するように生成された「ただのタスク(軽量プロセス)」として扱われます。
Linux カーネルには、プロセスとスレッドを明確に区別する「スレッド」という独立した概念がありません。両者はまとめて タスク として扱われ、clone() システムコールのフラグによって「どの資源を共有するか」が決まります。スレッドは、アドレス空間やファイルディスクリプタなどを共有した プロセス だ、と捉えるほうが実態に近いのです。
つまり、CPU が空いていても、1つの処理が勝手に複数コアへ分散されることはありません。分散させようとすると、アプリケーション側でかなり難しい実装が必要になります。
反面、CPU 数により同時実行プロセスを明確にすることができるため、見積はしやすくなります。
この理解は、コンテナの CPU リクエスト/リミットを見積もり、右サイジングするうえで欠かせません。むだに CPU を盛るのではなく、処理モデルに合わせて最適なサイズを選ぶ。
これは、まさに FinOps の第一歩です。ソフトウェア開発体制づくりについては IT コンサルティング でもご相談いただけます。
🥅 まとめ
FDD 20 枚の Slackware から始まった「軽量であること」へのこだわりは、30 有余年を経て、コンテナのベースイメージやクラウドの最適化という形で今も生きています。要点を 3 つにまとめます。
- 制約が設計を磨く — 500MB のディスクや 128kbps の回線という制約が、取捨選択の力を育てました。
- 軽量化はセキュリティとコストに効く — 不要なパッケージを削ることは、攻撃面の縮小とコスト削減を同時に実現します。
- 実行モデルを理解すると最適化できる — Linux が「純粋なマルチスレッド」ではないことを知ると、CPU の右サイジングの精度が上がります。
次のアクションとして、まずは自社のクラウド利用状況を「見える化」することから始めてみませんか。何が動いていて、何が本当に必要なのか。それを把握できたとき、最適化の第一歩が踏み出せます。